作者:Python进阶者
来源:Python爬虫与数据挖掘
前言
前几天有个叫【小明】的粉丝在问了一道关于Python处理文本可视化+语义分析的问题。
他要构建语料库,目前通过Python网络爬虫抓到的数据存在一个csv文件里边,现在要把数据放进txt里,表示不会,然后还有后面的词云可视化,分词,语义分析等,都不太会。
一、思路
内容稍微有点多,大体思路如下,先将csv中的文本取出,之后使用停用词做分词处理,再做词云图,之后做情感分析。
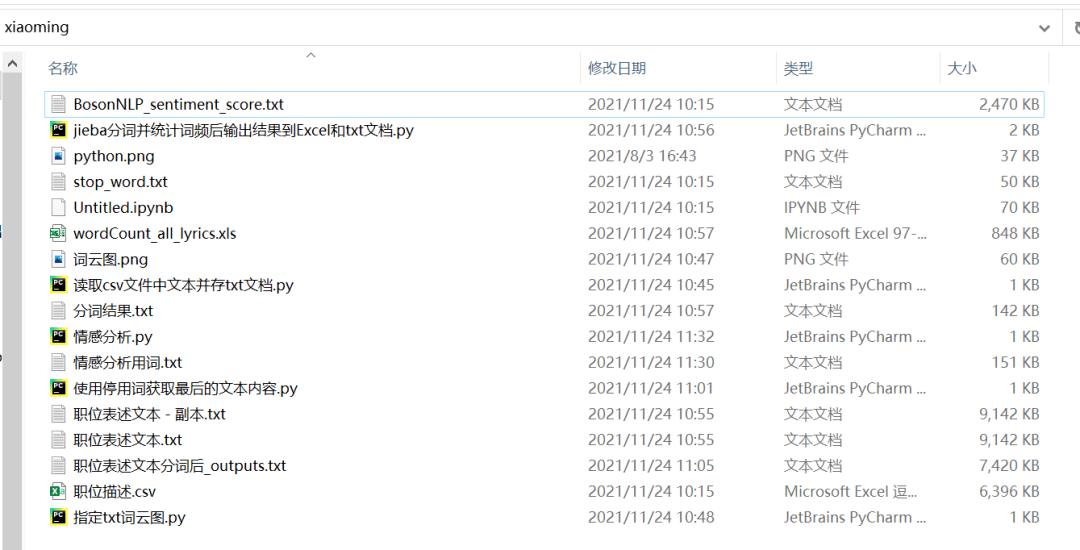
1、将csv文件中的文本逐行取出,存新的txt文件,这里运行代码《读取csv文件中文本并存txt文档.py》进行实现,得到文件《职位表述文本.txt》
2、运行代码《使用停用词获取最后的文本内容.py》,得到使用停用词获取最后的文本内容,生成文件《职位表述文本分词后_outputs.txt》
3、运行代码《指定txt词云图.py》,可以得到词云图;
4、运行代码《jieba分词并统计词频后输出结果到Excel和txt文档.py》,得到《wordCount_all_lyrics.xls》和《分词结果.txt》文件,将《分词结果.txt》中的统计值可以去除,生成《情感分析用词.txt》,给第五步情感分析做准备
5、运行代码《情感分析.py》,得到情感分析的统计值,取平均值可以大致确认情感是正还是负。
二、实现过程
1.将csv文件中的文本逐行取出,存新的txt文件
这里运行代码《读取csv文件中文本并存txt文档.py》进行实现,得到文件《职位表述文本.txt》,代码如下。
# coding: utf-8
import pandas as pd
df = pd.read_csv('./职位描述.csv', encoding='gbk')
# print(df.head())
for text in df['Job_Description']:
# print(text)
if text is not None:
with open('职位表述文本.txt', mode='a', encoding='utf-8') as file:
file.write(str(text))
print('写入完成')
2.使用停用词获取最后的文本内容
运行代码《使用停用词获取最后的文本内容.py》,得到使用停用词获取最后的文本内容,生成文件《职位表述文本分词后_outputs.txt》,代码如下:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
import jieba
# jieba.load_userdict('userdict.txt')
# 创建停用词list
def stopwordslist(filepath):
stopwords = [line.strip() for line in open(filepath, 'r', encoding='utf-8').readlines()]
return stopwords
# 对句子进行分词
def seg_sentence(sentence):
sentence_seged = jieba.cut(sentence.strip())
stopwords = stopwordslist('stop_word.txt') # 这里加载停用词的路径
outstr = ''
for word in sentence_seged:
if word not in stopwords:
if word != 't':
outstr += word
outstr += " "
return outstr
inputs = open('职位表述文本.txt', 'r', encoding='utf-8')
outputs = open('职位表述文本分词后_outputs.txt', 'w', encoding='utf-8')
for line in inputs:
line_seg = seg_sentence(line) # 这里的返回值是字符串
outputs.write(line_seg + 'n')
outputs.close()
inputs.close()
关键节点,都有相应的注释,你只需要替换对应的txt文件即可,如果有遇到编码问题,将utf-8改为gbk即可解决。
3.制作词云图
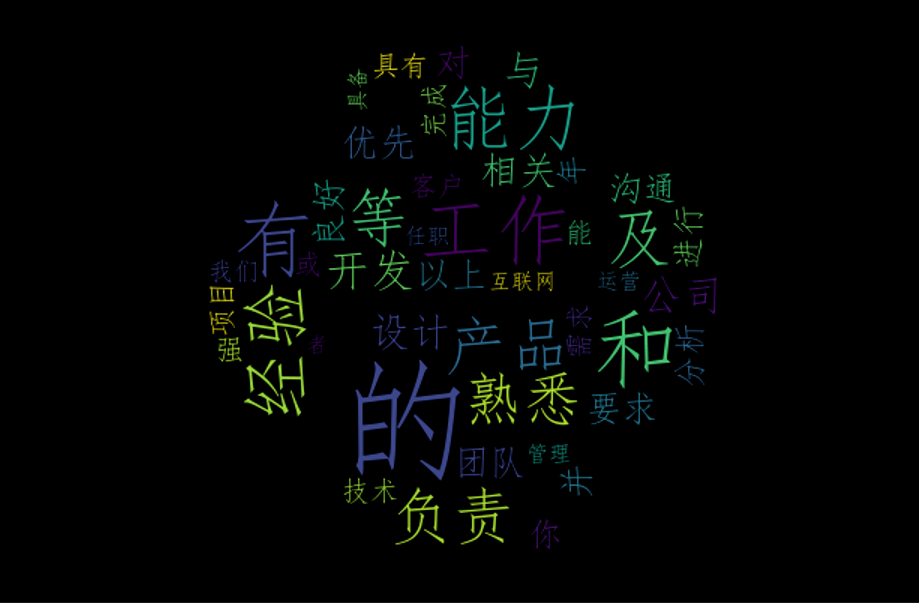
运行代码《指定txt词云图.py》,可以得到词云图,代码如下:
from wordcloud import WordCloud
import jieba
import numpy
import PIL.Image as Image
def cut(text):
wordlist_jieba=jieba.cut(text)
space_wordlist=" ".join(wordlist_jieba)
return space_wordlist
with open(r"C:UserspdcfiDesktopxiaoming职位表述文本.txt" ,encoding="utf-8")as file:
text=file.read()
text=cut(text)
mask_pic=numpy.array(Image.open(r"C:UserspdcfiDesktopxiaomingpython.png"))
wordcloud = WordCloud(font_path=r"C:/Windows/Fonts/simfang.ttf",
collocations=False,
max_words= 100,
min_font_size=10,
max_font_size=500,
mask=mask_pic).generate(text)
image=wordcloud.to_image()
# image.show()
wordcloud.to_file('词云图.png') # 把词云保存下来
如果想用你自己的图片,只需要替换原始图片即可。这里使用Python底图做演示,得到的效果如下:
4.分词统计
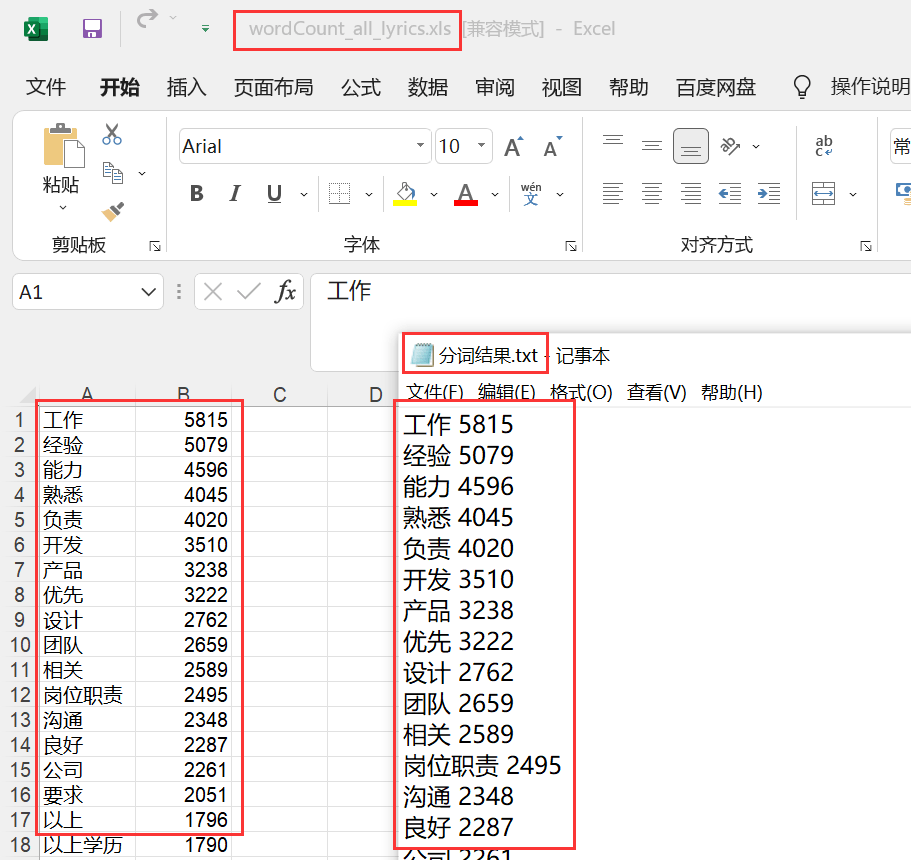
运行代码《jieba分词并统计词频后输出结果到Excel和txt文档.py》,得到《wordCount_all_lyrics.xls》和《分词结果.txt》文件,将《分词结果.txt》中的统计值可以去除,生成《情感分析用词.txt》,给第五步情感分析做准备,代码如下:
#!/usr/bin/env python3
# -*- coding:utf-8 -*-
import sys
import jieba
import jieba.analyse
import xlwt # 写入Excel表的库
# reload(sys)
# sys.setdefaultencoding('utf-8')
if __name__ == "__main__":
wbk = xlwt.Workbook(encoding='ascii')
sheet = wbk.add_sheet("wordCount") # Excel单元格名字
word_lst = []
key_list = []
for line in open('职位表述文本.txt', encoding='utf-8'): # 需要分词统计的原始目标文档
item = line.strip('nr').split('t') # 制表格切分
# print item
tags = jieba.analyse.extract_tags(item[0]) # jieba分词
for t in tags:
word_lst.append(t)
word_dict = {}
with open("分词结果.txt", 'w') as wf2: # 指定生成文件的名称
for item in word_lst:
if item not in word_dict: # 统计数量
word_dict[item] = 1
else:
word_dict[item] += 1
orderList = list(word_dict.values())
orderList.sort(reverse=True)
# print orderList
for i in range(len(orderList)):
for key in word_dict:
if word_dict[key] == orderList[i]:
wf2.write(key + ' ' + str(word_dict[key]) + 'n') # 写入txt文档
key_list.append(key)
word_dict[key] = 0
for i in range(len(key_list)):
sheet.write(i, 1, label=orderList[i])
sheet.write(i, 0, label=key_list[i])
wbk.save('wordCount_all_lyrics.xls') # 保存为 wordCount.xls文件
得到的txt和excel文件如下所示:
5.情感分析的统计值
运行代码《情感分析.py》,得到情感分析的统计值,取平均值可以大致确认情感是正还是负,代码如下:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
from snownlp import SnowNLP
# 积极/消极
# print(s.sentiments) # 0.9769551298267365 positive的概率
def get_word():
with open("情感分析用词.txt", encoding='utf-8') as f:
line = f.readline()
word_list = []
while line:
line = f.readline()
word_list.append(line.strip('rn'))
f.close()
return word_list
def get_sentiment(word):
text = u'{}'.format(word)
s = SnowNLP(text)
print(s.sentiments)
if __name__ == '__main__':
words = get_word()
for word in words:
get_sentiment(word)
# text = u'''
# 也许
# '''
# s = SnowNLP(text)
# print(s.sentiments)
# with open('lyric_sentiments.txt', 'a', encoding='utf-8') as fp:
# fp.write(str(s.sentiments)+'n')
# print('happy end')
基于NLP语义分析,程序运行之后,得到的情感得分值如下图所示:
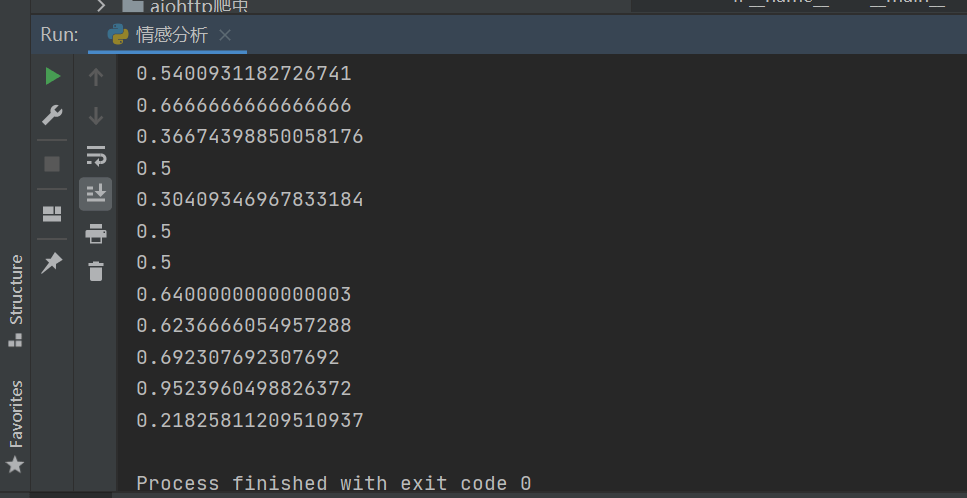
将得数取平均值,一般满足0.5分以上,说明情感是积极的,这里经过统计之后,发现整体是积极的。
四、总结
我是Python进阶者。本文基于粉丝提问,针对一次文本处理,手把手教你对抓取的文本进行分词、词频统计、词云可视化和情感分析,算是完成了一个小项目了。下次再遇到类似这种问题或者小的课堂作业,不妨拿本项目练练手,说不定有妙用噢,拿个高分不在话下!


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330