6. 方差分析
单因素多水平方差分析
例6.1 不同装配方式对生产的过滤系统数量的差异性检验
某城市过滤水系统生产公司,有A、B、C3种方式进行过滤水系统的装配,该公司为了研究三种装配方式生产的过滤系统数量是否有差异,从全体装配工人中抽取了15名工人,然后随机地指派一种装配方式,这样每个装配方式就有5个工人。在指派装配方法和培训工作都完成后,一周内对每名工人的装配过滤系统数量进行统计如下:
| 方法A |
方法B |
方法C |
| 58 |
58 |
48 |
| 64 |
69 |
57 |
| 55 |
71 |
59 |
| 66 |
64 |
47 |
| 67 |
68 |
49 |
请根据数据判断3种装配方式有无差异
分析过程:由于目标是判断3种装配方式有无差异,多样本的检验用方差分析
于是我们有了原假设和备择假设
:均值不全相等
import pandas as pd
import numpy as np
from scipy import stats
A = [58,64,55,66,67]
B = [58,69,71,64,68]
C = [48,57,59,47,49]
data = [A, B, C]
w, p = stats.levene(*data)
if p < 0.05:
print('方差齐性假设不成立')
f_value, p_value = stats.f_oneway(*data)
print("F_value:", f_value)
print("p_value:", p_value)
F_value: 9.176470588235295
p_value: 0.0038184120755124806
结论 选择显著性水平 0.05 的话,p = 0.0038 < 0.05,故拒绝原假设。支持三种装配方式装配数量均值不全相等的备则假设。
例6.2 不同优惠金额对购买转化率的差异性检验
某公司营销中心为了提升销量,针对某产品设计了3种不同金额的优惠,想测试三种优惠方式对于用户的购买转化率是否有显著影响,先收集到了三种不同方式在6个月内的转化率数据
请根据数据判断3种不同优惠金额的转化率有无差异
| 优惠A |
优惠B |
优惠C |
| 0.043 |
0.05 |
0.048 |
| 0.047 |
0.048 |
0.05 |
| 0.051 |
0.045 |
0.047 |
| 0.049 |
0.055 |
0.056 |
| 0.045 |
0.048 |
0.054 |
| 0.0469 |
0.0491 |
0.0509 |
分析过程:由于目标是判断3种不同金额的优惠券对于转化率有无差异,多样本的检验用方差分析
于是我们有了原假设和备择假设
:认为这几组之间的购买率不一样
P < 0.05 拒绝原假设,倾向于支持不同优惠金额购买率不一样的备择假设。认为不同优惠金额会对购买率产生影响
P > 0.05 无法拒绝原假设。认为不同优惠金额不会对购买率产生影响
import pandas as pd
import numpy as np
from scipy import stats

A = [0.043 , 0.047 , 0.051 , 0.049 , 0.045 , 0.0469]
B = [0.05  , 0.048 , 0.045 , 0.055 , 0.048 , 0.0491]
C = [0.048 , 0.05  , 0.047 , 0.056 , 0.054 , 0.0509]
data = [A, B, C]
w, p = stats.levene(*data)
if p < 0.05:
print('方差齐性假设不成立')
f_value, p_value = stats.f_oneway(*data)
print("F_value:", f_value)
print("p_value:", p_value)
结论 选择显著性水平 0.05 的话,p = 0.1311 > 0.05,故无法拒绝原假设。认为不同优惠金额不会对购买率产生影响
双因素方差分析
1.双因素方差分析(等重复实验)
这里的等重复实验,意思就是针对每个组合做大于等于两次的实验,比如下方例子中表里A1和B1的组合里面有2个数字,即说明做了两次实验,如果是3个数字则说明3次实验,依次类推。
例6.3 不同燃料种类和推进器的火箭射程差异性检验
火箭的射程与燃料的种类和推进器的型号有关,现对四种不同的燃料与三种不同型号的推进器进行试验,每种组合各发射火箭两次,测得火箭的射程如表(以海里计)(设显著性水平为0.05)
| 燃料 |
B1 |
B2 |
B3 |
| A1 |
58.2 , 52.6 |
56.2 , 41.2 |
65.3 , 60.8 |
| A2 |
49.1 , 42.8 |
54.1 , 50.5 |
51.6 , 48.4 |
| A3 |
60.1 , 58.3 |
70.9 , 73.2 |
39.2 , 40.7 |
| A4 |
75.8 , 71.5 |
58.2 , 51.0 |
48.7 , 41.0 |
import numpy as np
import pandas as pd
d = np.array([[58.2, 52.6, 56.2, 41.2, 65.3, 60.8],
[49.1, 42.8, 54.1, 50.5, 51.6, 48.4],
[60.1, 58.3, 70.9, 73.2, 39.2, 40.7],
[75.8, 71.5, 58.2, 51.0, 48.7,41.4]
])
data = pd.DataFrame(d)
data.index=pd.Index(['A1','A2','A3','A4'],name='燃料')
data.columns=pd.Index(['B1','B1','B2','B2','B3','B3'],name='推进器')
data = data.reset_index().melt(id_vars =['燃料'])
data = data.rename(columns={'value':'射程'})
data.sample(5)
| 燃料 |
推进器 |
射程 |
| A2 |
B3 |
48.4 |
| A3 |
B2 |
73.2 |
| A3 |
B3 |
39.2 |
| A4 |
B1 |
71.5 |
| A2 |
B2 |
54.1 |
import statsmodels.api as sm
from statsmodels.formula.api import ols
model = ols('射程~C(燃料) + C(推进器)+C(燃料):C(推进器)', data =data).fit()
anova_table = sm.stats.anova_lm(model, typ=2)
anova_table
|
sum_sq |
df |
F |
PR(>F) |
| C(燃料) |
261.675 |
3 |
4.41739 |
0.025969 |
| C(推进器) |
370.981 |
2 |
9.3939 |
0.00350603 |
| C(燃料):C(推进器) |
1768.69 |
6 |
14.9288 |
6.15115e-05 |
| Residual |
236.95 |
12 |
nan |
nan |
结论:
对燃料因素来说,其p = 0.0259 < 0.05 所以拒绝,认为燃料对射程影响显著;
对推进器因素来说,其p = 0.0035 < 0.05,所以拒绝,认为推进器对射程影响显著;
对燃料和推进器的交互因素来说,其p = 0.000062< 0.05,所以拒绝,认为交互因素其对射程影响显著。
2.双因素方差分析(无重复实验)
在等重复实验中,我们为了检验实验中两个因素的交互作用,针对每对组合至少要做2次以上实验,才能够将交互作用与误差分离开来,在处理实际问题时候,如果我们一直不存在交互作用,或者交互作用对实验指标影响极小,则可以不考虑交互作用,此时每对组合只做一次实验,类似下方例子中的表中数据:
例6.4 不同时间、不同地点颗粒状物含量差异性检验 无重复实验
下面给出了在5个不同地点、不同时间空气中的颗粒状物(单位:mg/m°)含 量的数据记录于表中,试在显著性水平下检验不同时间、不同地点颗粒状物含量有无显著差异?(假设两者没有交互作用〉
| 因素B -地点 |
| 因素A - 时间 |
| 1995年10月 |
76 |
67 |
81 |
56 |
51 |
| 1996年01月 |
82 |
69 |
96 |
59 |
70 |
| 1996年05月 |
68 |
59 |
67 |
54 |
42 |
| 1996年08月 |
63 |
56 |
64 |
58 |
37 |
import numpy as np
import pandas as pd
d = np.array([
[76,67,81,56,51],
[82,69,96,59,70],
[68,59,67,54,42],
[63,56,64,58,37]])
data = pd.DataFrame(d)
data.index=pd.Index(['1995年10月','1996年01月','1996年05月','1996年08月'],name='时间')
data.columns=pd.Index(['B1','B2','B3','B4','B5'],name='地点')
data = data.reset_index().melt(id_vars =['时间'])
data = data.rename(columns={'value':'颗粒状物含量'})
data.sample(5)
随机查看5条转化后的数据:
| 时间 |
地点 |
颗粒状物含量 |
| 1996年05月 |
B4 |
54 |
| 1995年10月 |
B4 |
56 |
| 1996年05月 |
B3 |
67 |
| 1996年01月 |
B2 |
69 |
| 1996年01月 |
B3 |
96 |
import statsmodels.api as sm
from statsmodels.formula.api import ols
model = ols('颗粒状物含量~C(时间) + C(地点)', data =data).fit()
anova_table = sm.stats.anova_lm(model, typ=2)
anova_table
|
sum_sq |
df |
F |
PR(>F) |
| C(时间) |
1182.95 |
3 |
10.7224 |
0.00103293 |
| C(地点) |
1947.5 |
4 |
13.2393 |
0.000234184 |
| Residual |
441.3 |
12 |
nan |
nan |
结论:
对时间因素来说,其p = 0.001033 < 0.05 所以拒绝,认为时间对颗粒状物含量影响显著;
对地点因素来说,其p = 0.000234 < 0.05,所以拒绝,认为地点对颗粒状物含量影响显著;
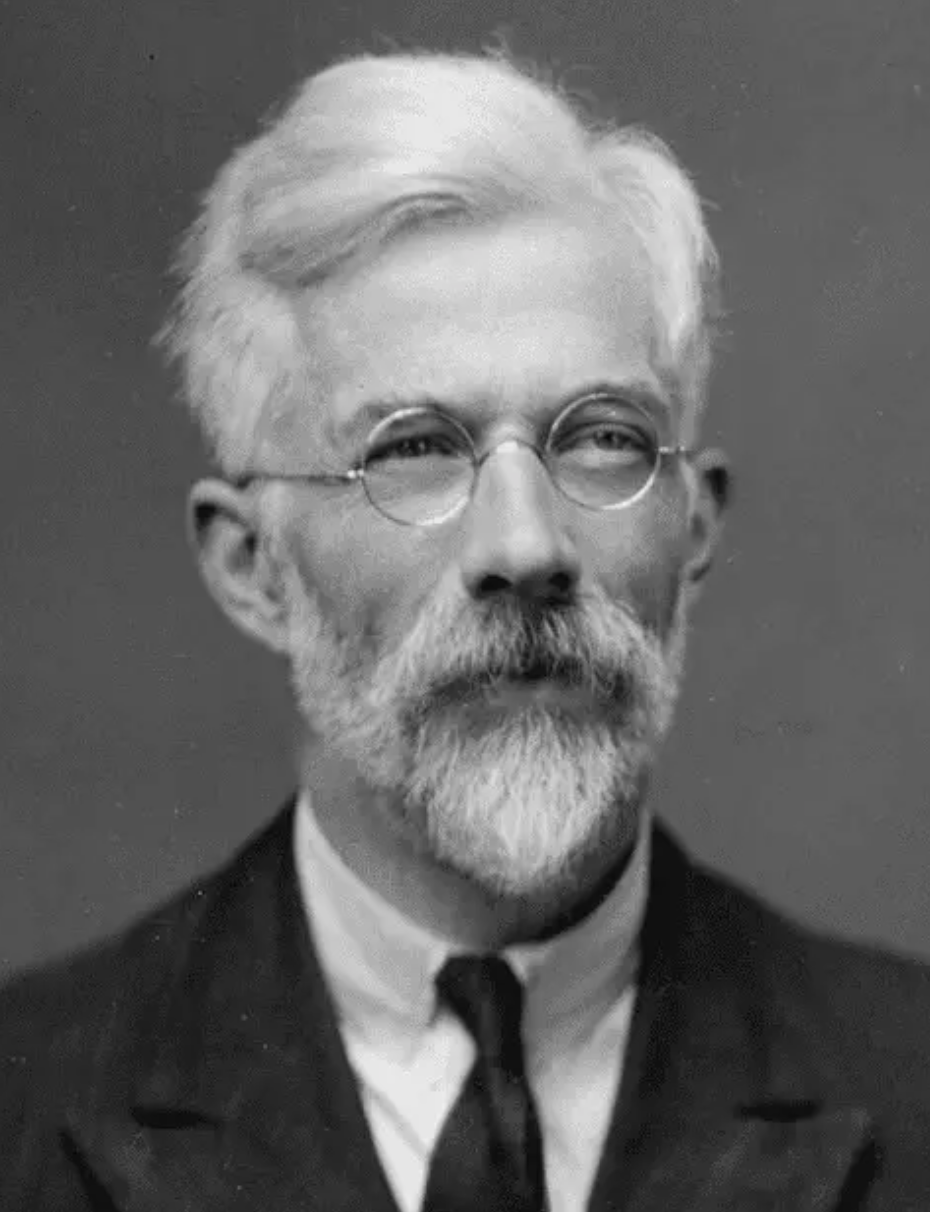 致敬:数理统计的大半江山的创造者——费希尔
下期将为大家带来《统计学极简入门》之相关分析
这里分享一个你一定用得到的小程序——CDA数据分析师考试小程序。
它是专为CDA数据分析认证考试报考打造的一款小程序。可以帮你快速报名考试、查成绩、查证书、查积分,通过该小程序,考生可以享受更便捷的服务。
扫码加入CDA小程序,与圈内考生一同学习、交流、进步!


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330