R语言与回归分析几个假设的检验
一、从线性回归的假设说起
对于线性回归而言,若要求回归估计有一些良好性质比如无偏性,就需要加上一些假定条件。比如要达到估计的无偏性,我们通常需要加上高斯-马尔科夫条件:
A1、对参数而言的线性性
A2、样本的随机抽样性
A3、误差的条件均值为0
A4、不存在完全共线性
A5、同方差假设
在上述条件上加上误差项服从正态分布,就得到了经典线性回归模型的6大假定。保证了估计的良好性质。

现在我们来考虑一下这几个条件,它们真的十分容易达到吗?
我们先从比较容易满足的的假设A4入手分析:完全共线性导致的结果是最小二乘的结果不唯一。所以这里要求的是数据相关性不能为1,但并不是不能有相关性。导致完全共线性的原因不外乎以下三个:1、错误的将一系列已建立线性关系的因变量包括在处理的数据中(但其实这个的相关度还是达不到1的,但是会影响到回归的效果,更加会影响到你的解释)2、处理虚拟变量不当导致的错误。用r个虚拟变量表示离散变量取值时,多重共线性在所难免(这个是真正的完全共线性,因为离散变量表达了所有的情况)3、样本量过小导致的无法识别。这个也只能增加样本量来解决问题。
再来看A2,这个我们通过数据收集方式的先验知识来判断最优,我们不知道是也可以通过残差的独立性来看,在R的car包中提供了一个可做独立性检测(durbin-watson检验)的函数durbinWatsonTest()。该检验适用于时间独立数据,对于非聚集型数据并不适用。
看A3说的是误差项里不包括自变量的任何信息,这个在作解释是十分重要的。也可以证明均值为0的条件总是可以达到的,通过适当变换。
A1、A5就没有那么容易达到。虽然他们对无偏性的影响并不大,最小二乘的估计量仍是无偏且一致的(相合的),但是有效性时会受到影响的。
那么,我们现在的问题就是如何判定这两个假定成立?
二、异方差的线性回归
关于异方差我们必须注意到这样一个事实:即便误差具有一致的方差,最小二乘残差仍有不等的方差。我们可以通过对学生残差(主要是排除一些异常值,让数据平稳一些)根据拟合值绘制散点图来辨别之。当然我们也有统计的办法如Breusch-Pagan检验
在R中,扩展包lmtest中的Breusch-Pagan检验。或者利用car包中的ncv.test()函数。二者工作的原理都是相同的。在回归之后,我们可以对拟合的模型采用bptest()函数
unrestricted<-lm(z~x)
bptest(unrestricted)
这将得到检验的“学生化的”(studentized)结果。如果为了保持与其他软件结论的一致性(包括ncv.test()),我们可以设置studentize=FALSE
我们来看一个例子:以下数据取自伍德里奇的《计量经济学导论》均保留原数据名
library(foreign)
B<-read.dta("D:/R/data/SAVING.dta")#导入数据
library(lmtest)
result2<-lm(sav~inc+size+educ+age+black,data=B)
bptest(result2)
studentized Breusch-Pagan test
data: result2
BP =5.5756, df = 5, p-value = 0.3497 #从这里看得出数据是不具有异方差性的
C<-read.dta("D:/R/data/SMOKE.dta")
result3<-lm(cigs~log(income)+cigpric+educ+age+restaurn,data=C)
bptest(result3)
studentized Breusch-Pagan test
data: result3
BP =11.0583, df = 5, p-value = 0.05024#这里可以认为数据有异方差性,但表现的不是特别强烈
如果去掉“学生化”我们可以得到:
>result3<-lm(cigs~log(income)+cigpric+educ+age+restaurn,data=C)
>bptest(result3,studentize=FALSE)
Breusch-Pagan test
data: result3
BP =24.6376, df = 5, p-value = 0.0001637#这里可以看出异方差性是很明显的。
这也说明了学生化对异方差的修正作用。
对smoke数据作图分析也可以得到一个不错的,直观的结果。
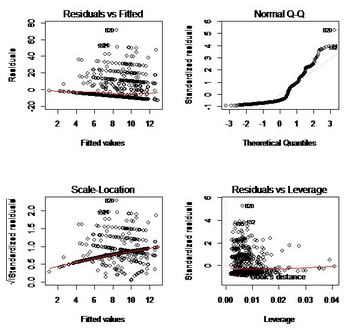
异方差的存在性影响ols估计量的有效性,使得t检验与F检验不再有效,所以存在异方差时,必须使用异方差稳健标准误代替标准误。一般的,我们使用white一致标准误来做假设检验。
为了计算异方差一致性的协方差矩阵,我们可以利用car包中的hccm()函数,而不是vcov()。
sandwich包中的vcovHC()命令可以实现同样的功能。同时利用vcovHAC()或者NeweyWest()函数可以进行异方差和自相关稳健性Newey—West估计(注1)。
library(sandwich)
NeweyWest(result3)
neweywest<- coeftest(result3, vcov = NeweyWest(result3))
print(neweywest)#得出稳健的估计
summary(result3)
对比两个估计的结果:(注意P值的变化)
稳健估计的:
Estimate Std.Error t value Pr(>|t|)
(Intercept) -2.054967 8.496552 -0.2419 0.808951
log(income) 1.891021 0.642539 2.9430 0.003344 **
cigpric -0.004685 0.099792 -0.0469 0.962567
educ -0.377021 0.169621 -2.2227 0.026513 *
age -0.045268 0.023225 -1.9491 0.051633.
restaurn -2.945906 1.042941 -2.8246 0.004851 **
---
Signif.codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05‘.’ 0.1 ‘ ’ 1
直接回归估计的:
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -2.054967 8.778358 -0.234 0.81497
log(income) 1.891021 0.712092 2.656 0.00807 **
cigpric -0.004685 0.102518 -0.046 0.96356
educ -0.377021 0.167975 -2.244 0.02507 *
age -0.045268 0.028682 -1.578 0.11490
restaurn -2.945906 1.127952 -2.612 0.00918 **
---
Signif.codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05‘.’ 0.1 ‘ ’ 1
也可以看到协方差阵的变化:
vcovHAC(result3)
vcov(result3)
三、线性性的假设检验
car包中提供了一个函数可以自动的进行线性假设检验。根据我们对模型的设定,它既可以用一般的方法或调整后的协方差矩阵进行F或Wald检验。例如,如果我们有一个包括常数项的五个参数的模型,并且我们的零假设如下
H0:β0 =0, β3+β4=0
我们可以用如下的命令加以实现
unrestricted<-lm(y~x1+x2+x3+x4)
rhs<-c(0,1)
hm<-rbind<-(c(1,0,0,0,0),c(0,0,1,1,0))
linear.hypothesis(unrestricted,hm,rhs)
如果unrestricted是由lm得到的,默认状态下将会进行F检验。如果是由glm得到的,取而代之的将是Kai方检验。检验的类型可以通过type进行修改。
同样,如果我们想利用异方差或自相关稳健标准误进行检验,我们既可以通过设定white.adjust=TRUE来使用white标准误,也可以利用vcov计算我们自己的协方差矩阵。例如,如果我们想使用上述的Newey-West修正协方差矩阵,我们可以进行如下的设定:
linear.hypothesis(unrestricted,hm, rhs, vcov=NeweyWest(unrestricted))(注2)
四、附注
注1:Newey-West
的自相关异方差一致性估计:当异方差的形式未知的时候,加权最小二乘法(WLS)得到的估计结果虽然仍具有一致性,但是不在有效。为了解决这一问题,White(1980)提出了Heteroskedasticity
Consistent Covariances 方法使存在异方差时能够对协方差矩阵进行一致性估计,而无须知道异方差的形式,但是 White
提出的方法假定序列的残差是不存在自相关的,为了解决这一问题,Newey-West(1987)提出了一个更为一般的估计量,使存在异方差和自相关是仍然能对协方差矩阵进行一致性估计。
注2、设定white.adjust=TRUE将会通过提高white估计量的精度来修正异方差;如果要使用经典的white估计量,我们可以设定white.adjust="hc0"
注3、对于异方差检验的另一函数
调用library(lmtest)
Goldfeld-Quandt
Test,GQ检验的思想是先把时间序列数据按顺序排列,然后截去一定数量的中间段数据,留下的数据就自然分成两组,对这两组数据各自回归获得各组的残差平方和,把两个残差平方和除以各自的自由度,然后再相除,就获得了GQ统计量,这是一个F统计量。GQ检验的零假设为回归不存在异方差;备折假设则为存在异方差。
R语言中,使用函数gqtest()进行检验。
gqtest(formula, point=0.5, fraction=0, alternative=c("greater", "two.sided", order.by=NULL, data=list())
GQ检验的思想是对数据回归得到残差序列,然后把残差作为被解释变量,原方程各解释变量作为解释变量做回归,得到bp的统计量
注4、异方差的手动算法
## packages and data
library("AER")
data("CigarettesB")
## regression
cig_lm2 < - lm(packs ~ price + income, data = CigarettesB)
## auxiliary regression
aux <- residuals(cig_lm2)^2
aux_lm <- lm(aux ~ income * price + I(income^2) + I(price^2),
data = CigarettesB)
## test statistic
nrow(CigarettesB) * summary(aux_lm)$r.squared
pchisq( nrow(CigarettesB) * summary(aux_lm)$r.squared,df=5,lower.tail=F)
[1] 0.007896581


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330