Python实现基于二叉树存储结构的堆排序算法示例
本文实例讲述了Python实现基于二叉树存储结构的堆排序算法。分享给大家供大家参考,具体如下:
既然用Python实现了二叉树,当然要写点东西练练手。
网络上堆排序的教程很多,但是却几乎都是以数组存储的数,直接以下标访问元素,当然这样是完全没有问题的,实现简单,访问速度快,也容易理解。
但是以练手的角度来看,我还是写了一个二叉树存储结构的堆排序
其中最难的问题就是交换二叉树中两个节点。
因为一个节点最多与三个节点相连,那么两个节点互换,就需要考虑到5个节点之间的关系,也需要判断是左右孩子,这将是十分繁琐的,也很容易出错。
class Tree:
def __init__(self, val = '#', left = None, right = None):
self.val = val
self.left = left
self.right = right
self.ponit = None
self.father = None
self.counter = 0
#前序构建二叉树
def FrontBuildTree(self):
temp = input('Please Input: ')
node = Tree(temp)
if(temp != '#'):
node.left = self.FrontBuildTree()
node.right = self.FrontBuildTree()
return node#因为没有引用也没有指针,所以就把新的节点给返回回去
#前序遍历二叉树
def VisitNode(self):
print(self.val)
if(self.left != None):
self.left.VisitNode()
if(self.right != None):
self.right.VisitNode()
#中序遍历二叉树
def MVisitTree(self):
if(self.left != None):
self.left.MVisitTree()
print(self.val)
if(self.right != None):
self.right.MVisitTree()
#获取二叉树的第dec个节点
def GetPoint(self, dec):
road = str(bin(dec))[3:]
p = self
for r in road:
if (r == '0'):
p = p.left
else:
p = p.right
#print('p.val = ', p.val)
return p
#构建第一个堆
def BuildHeadTree(self, List):
for val in List:
#print('val = ', val, 'self.counter = ', self.counter)
self.ponit = self.GetPoint(int((self.counter + 1) / 2))
#print('self.ponit.val = ', self.ponit.val)
if (self.counter == 0):
self.val = val
self.father = self
else:
temp = self.counter + 1
node = Tree(val)
node.father = self.ponit
if(temp % 2 == 0):#新增节点为左孩子
self.ponit.left = node
else:
self.ponit.right = node
while(temp != 0):
if (node.val < node.father.val):#如果新增节点比其父亲节点值要大
p = node.father#先将其三个链子保存起来
LeftTemp = node.left
RightTemp = node.right
if (p.father != p):#判断其不是头结点
if (int(temp / 2) % 2 == 0):#新增节点的父亲为左孩子
p.father.left = node
else:
p.father.right = node
node.father = p.father
else:
node.father = node#是头结点则将其father连向自身
node.counter = self.counter
self = node
if(temp % 2 == 0):#新增节点为左孩子
node.left = p
node.right = p.right
if (p.right != None):
p.right.father = node
else:
node.left = p.left
node.right = p
if (p.left != None):
p.left.father = node
p.left = LeftTemp
p.right = RightTemp
p.father = node
temp = int(temp / 2)
#print('node.val = ', node.val, 'node.father.val = ', node.father.val)
#print('Tree = ')
#self.VisitNode()
else:
break;
self.counter += 1
return self
#将头结点取出后重新调整堆
def Adjust(self):
#print('FrontSelfTree = ')
#self.VisitNode()
#print('MSelfTree = ')
#self.MVisitTree()
print('Get ', self.val)
p = self.GetPoint(self.counter)
#print('p.val = ', p.val)
#print('p.father.val = ', p.father.val)
root = p
if (self.counter % 2 == 0):
p.father.left = None
else:
p.father.right = None
#print('self.left = ', self.left.val)
#print('self.right = ', self.right.val)
p.father = p#将二叉树最后一个叶子节点移到头结点
p.left = self.left
p.right = self.right
while(1):#优化是万恶之源
LeftTemp = p.left
RightTemp = p.right
FatherTemp = p.father
if (p.left != None and p.right !=None):#判断此时正在处理的结点的左后孩子情况
if (p.left.val < p.right.val):
next = p.left
else:
next = p.right
if (p.val < next.val):
break;
elif (p.left == None and p.right != None and p.val > p.right.val):
next = p.right
elif (p.right == None and p.left != None and p.val > p.left.val):
next = p.left
else:
break;
p.left = next.left
p.right = next.right
p.father = next
if (next.left != None):#之后就是一系列的交换节点的链的处理
next.left.father = p
if (next.right != None):
next.right.father = p
if (FatherTemp == p):
next.father = next
root = next
else:
next.father == FatherTemp
if (FatherTemp.left == p):
FatherTemp.left = next
else:
FatherTemp.right = next
if (next == LeftTemp):
next.right = RightTemp
next.left = p
if (RightTemp != None):
RightTemp.father = next
else:
next.left = LeftTemp
next.right = p
if (LeftTemp != None):
LeftTemp.father = next
#print('Tree = ')
#root.VisitNode()
root.counter = self.counter - 1
return root
if __name__ == '__main__':
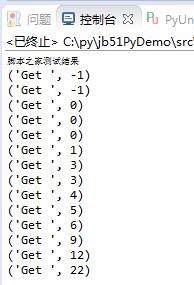
print("脚本之家测试结果")
root = Tree()
number = [-1, -1, 0, 0, 0, 12, 22, 3, 5, 4, 3, 1, 6, 9]
root = root.BuildHeadTree(number)
while(root.counter != 0):
root = root.Adjust()
运行结果:


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330